
exasock 跟 Onload 是兩套不用改程式的 kernel bypass:啟動指令前面加上 exasock 或 onload,就會攔下程式對 socket 的呼叫,改由使用者空間函式庫直接跟網卡收送,不經過 kernel 的網路處理。這次用同一支回覆程式,在兩張網卡上各跟 kernel 比,量出三個結果:
ss 也看不到這支程式,要改用 Onload、exasock 各自的工具確認。每輪送 10000 個請求,每 1 ms 一個多播封包,回覆程式收到就回一個。交換器把請求和回覆都送到 ExaNIC X25 的 port1,由 port1 對兩個封包各打一個硬體時戳,相減就是收發延遲。Onload 只加速 Solarflare 網卡,exasock 只加速 ExaNIC,所以分兩組量:X4522 回覆時由 X25 的 port0 送請求,X25 的 port0 回覆時改由 X4522 送請求。
回覆程式是同一個執行檔,放在隔離的 CPU 1,只換啟動方式。每輪先對執行檔算 md5(依檔案內容算出的雜湊值,內容一改就不同),結果都相同,代表沒有重新編譯。每種跑法量兩輪,兩輪中位數相差不到 0.05 µs:
| 跑法 | 啟動方式 | 等封包的方式 |
|---|---|---|
| kernel | ./udp_echo |
中斷喚醒(busy_read 50,先輪詢 50 µs) |
| kernel busy poll | 先 sysctl -w net.core.busy_read=2000 |
kernel 替程式輪詢網卡,最多 2 ms |
| Onload 預設 | onload ./udp_echo |
中斷喚醒(手冊寫預設不輪詢) |
| Onload latency | onload --profile=latency ./udp_echo |
輪詢最多 100 ms,之後改等中斷 |
| exasock | exasock ./udp_echo |
一律輪詢(手冊列為已知限制) |
| 跑法 | 中位數 | p99.9 | 程式的 CPU 使用率 |
|---|---|---|---|
| kernel | 4.16 µs | 4.58 µs | 3.7% |
| kernel busy poll | 3.81 µs | 4.32 µs | 74.9% |
| Onload 預設 | 2.95 µs | 3.31 µs | 0.0% |
| Onload latency | 1.21 µs | 1.56 µs | 76.4% |
在伺服器上用存下來的封包檔重算,每一行是一輪 10000 個請求的收發延遲分布,最大值都是第一個請求:

CPU 使用率是 ps 從程式啟動算到量完的平均,其中約 10 秒在送請求,前後共 4 秒沒有請求。kernel busy poll 跟 Onload latency 約 75%,代表送請求期間一直在輪詢;kernel 的 3.7% 來自每次等下一個請求前,先輪詢的那 50 µs。
Onload 預設模式用自己的一條中斷喚醒程式,這條中斷在 Onload 第一次啟動時才建立,開機時把中斷設到 CPU 25 的設定管不到它,這次落在 CPU 17。表中 2.95 µs 是把它移到程式那顆 CPU 1 後量的,留在 CPU 17 是 3.52 µs。
| 跑法 | 網卡中斷 | 中位數 | p99.9 | 程式的 CPU 使用率 |
|---|---|---|---|---|
| kernel | CPU 1 | 3.42 µs | 3.80 µs | 0.0% |
| kernel busy poll | CPU 1 | 3.46 µs | 3.86 µs | 0.0% |
| exasock | CPU 25 | 1.58 µs | 1.83 µs | 95.3% |
| exasock(中斷移到 CPU 1) | CPU 1 | 2.25 µs | 2.76 µs | 97.8% |
同樣用存下來的封包檔重算,最後一行 exasock-irq-on-cpu1 是網卡中斷移到 CPU 1 的那組:

ExaNIC 的驅動不支援 busy poll:busy_read 開到 2000,程式的 CPU 使用率還是 0%,中位數也沒變。exasock 則從程式啟動就一直輪詢,CPU 使用率接近 100%。這時 kernel 的網卡驅動照樣收到每個請求,每個都觸發一次中斷。網卡中斷放在程式那顆 CPU 1 時,中位數從 1.58 µs 增加到 2.25 µs,通常是因為中斷處理打斷了正在輪詢的程式,所以網卡中斷要放在別顆 CPU。這跟靠中斷喚醒程式的跑法相反:kernel 跟 Onload 預設模式都是中斷跟程式放同一顆比較快。
X4522 上,Onload latency 跟 kernel 的差距可以用 kernel busy poll 拆成兩段(X25 的 busy poll 沒有作用):
| 比較 | 中位數 | 差距 | 差異來源 |
|---|---|---|---|
| kernel → kernel busy poll | 4.16 → 3.81 µs | 0.35 µs | 不用等中斷、喚醒程式 |
| kernel busy poll → Onload latency | 3.81 → 1.21 µs | 2.60 µs | kernel 的網路處理換成使用者空間函式庫 |
量測時 kernel 的網卡中斷跟程式在同一顆隔離的 CPU、C-state 也關閉,等待只佔 0.35 µs,Onload 省下的主要是 kernel 的網路處理。如果程式放在一般的 CPU、又被其他程式佔滿,最慢的幾個請求在 kernel 收到後,可能要等上毫秒級,程式才拿到。
| 觀察方式 | kernel | Onload(X4522) | exasock(X25) |
|---|---|---|---|
抓封包(tcpdump) |
請求、回覆都抓得到 | 都抓不到 | 都抓不到 |
列出 socket(ss,取代 netstat 的指令) |
列得出 | 列不出 | 列不出 |
kernel 的 UDP 收送計數(nstat) |
有算 | 0 | 0 |
| 網卡介面的收送計數 | 都有算 | 都有算 | 收有算、送沒算 |
| 確認有加速 | — | 啟動訊息、onload_stackdump |
EXASOCK_DEBUG=1、exasock-stat |
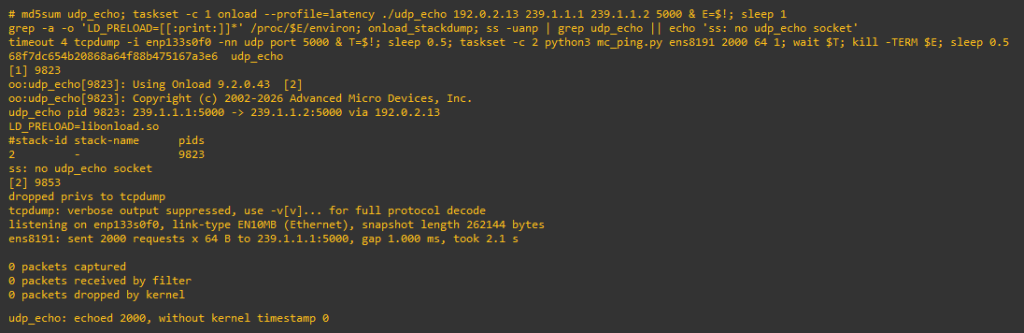
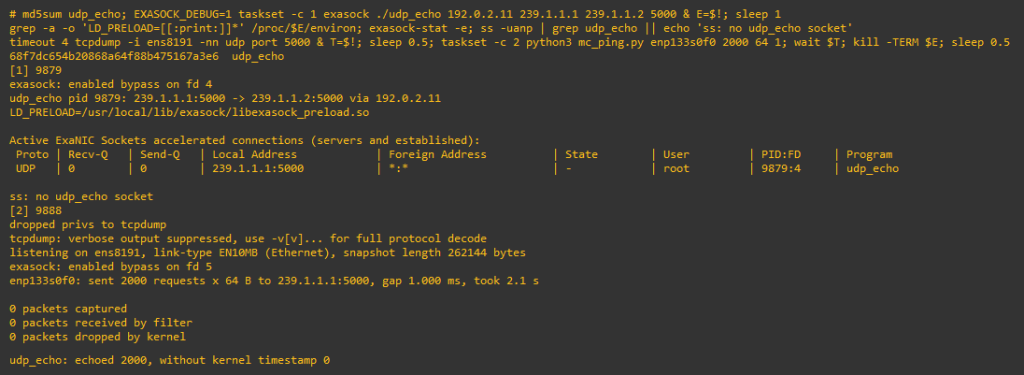
下面兩張截圖用同一個執行檔,分別以 onload、exasock 啟動並送 2000 個請求。程式都回了 2000 個,同時開著的 tcpdump 卻抓到 0 個封包,ss 也列不出這支程式,只有 onload_stackdump、exasock-stat 列得出來。所以排查時 tcpdump 抓不到封包,不代表沒有流量:
Onload 手冊寫明:在資源不夠、建不起加速的 socket 時,它會自動改建一般的 kernel socket。程式收不到錯誤,照常收發,延遲卻回到 kernel 的水準,不主動確認就不會發現。這個行為由環境變數 EF_NO_FAIL 控制,預設是 1;改成 0,建不起來時就會把錯誤回報給程式。
要拿到這次 1.2~1.6 µs 的延遲,Solarflare 網卡用 Onload 的 latency profile,ExaNIC 用 exasock,程式放在一顆獨佔的隔離 CPU 上輪詢。代價是那顆 CPU 一直被佔著,kernel 的工具也看不到流量,所以適合延遲敏感、執行緒少的程式。下面幾種不適合,前三種出自 exasock 手冊的已知限制:
onload、exasock 靠 LD_PRELOAD 在程式啟動時先載入加速函式庫,只對動態連結的程式有效。| 項目 | 做法 | 時機 | 不符合時 |
|---|---|---|---|
| 確認有加速 | onload_stackdump、exasock-stat 列得出這支程式;Onload 設 EF_NO_FAIL=0 |
部署、重啟之後 | 交易時段 P1,盤後 P2 |
| 輪詢的 CPU | 放在隔離的 CPU;使用率接近 100% 是正常的,CPU 使用率告警要排除這幾顆 | 上線前 | 改告警設定 |
| 中斷位置 | 存中斷綁定的基線:Onload 預設模式的中斷跟程式同一顆,exasock 的網卡中斷放別顆 | 程式啟動之後 | 列為 P2 |
| 排查 | 改用 onload_stackdump、exasock-stat 跟交換器的 port 計數器,不看 tcpdump、ss |
故障時 | — |
明天談調校成果怎麼驗證:只看平均值不夠,要看 p99、p99.9 跟抖動。


 iThome鐵人賽
 看影片追技術